「Agentic RAG」是 2025-2026 RAG 社群最常被誤讀的詞——多數人以為它是「加 agent 包裝的 RAG」,但微軟第 5 課把它定義成完全不同的東西:讓 LLM 擁有自己的推理過程,自動 rewrite 失敗查詢、換 retrieval 方法、call 不同 tool、在預設邊界內迭代,證據足夠或達到上限時停止。這篇拆解 Lesson 05、對位傳統 RAG 給出 5 個關鍵差別,以及最容易被忽略的問題:什麼時候別用 Agentic RAG。
為什麼這課值得 RAG 老手再看一次
如果你已經做過幾個 RAG 專案、可能會覺得「Agentic RAG」聽起來像行銷詞。但微軟給的定義意外精準:傳統 RAG 是「retrieval-then-read」、Agentic RAG 是「retrieval ↔ reasoning 依證據與停止條件互相迭代」。差別不是加不加 agent、是誰擁有推理過程。傳統 RAG 是開發者預先設計好 chain-of-thought、模型照走;Agentic RAG 是模型自己決定下一步要做什麼。
這個 reframing 重要的原因:你做 RAG 評估時、應該問的問題從「我的 chunk strategy 對不對」「embedding model 準不準」變成「我的 agent 在拿到爛 retrieval 之後、會不會自己 rewrite query 再試一次」。後者是 Agentic RAG 真正的價值點、也是它最容易被低估的能力。
Traditional RAG vs Agentic RAG — 5 個關鍵差別
| 維度 | Traditional RAG | Agentic RAG |
|---|---|---|
| 推理 ownership | 開發者預先設計 chain | 模型自己決定下一步 |
| 查詢失敗處理 | 依預設流程處理,可另設重試或備援 | rewrite query、換 tool、換 retrieval 方法再試 |
| 多 retrieval 方法 | 檢索路徑由開發者預先設計 | 動態混用 vector search + SQL + Bing + 自家 API |
| 跨步驟記憶 | 狀態與記憶是否保留,依流程設計 | state + memory 跨步驟、避免重複嘗試 |
| 停止條件 | 跑完預設 chain 就停 | 評估證據;受迭代、token/時間上限與人工介入條件約束 |
5 個維度的共通點:從「人定流程、模型執行」變「模型定流程、人定邊界」。多輪模型與工具呼叫會增加 token 與延遲;對 malformed query、資訊缺口或 cross-source 驗證是否有幫助,仍須用任務評估確認。
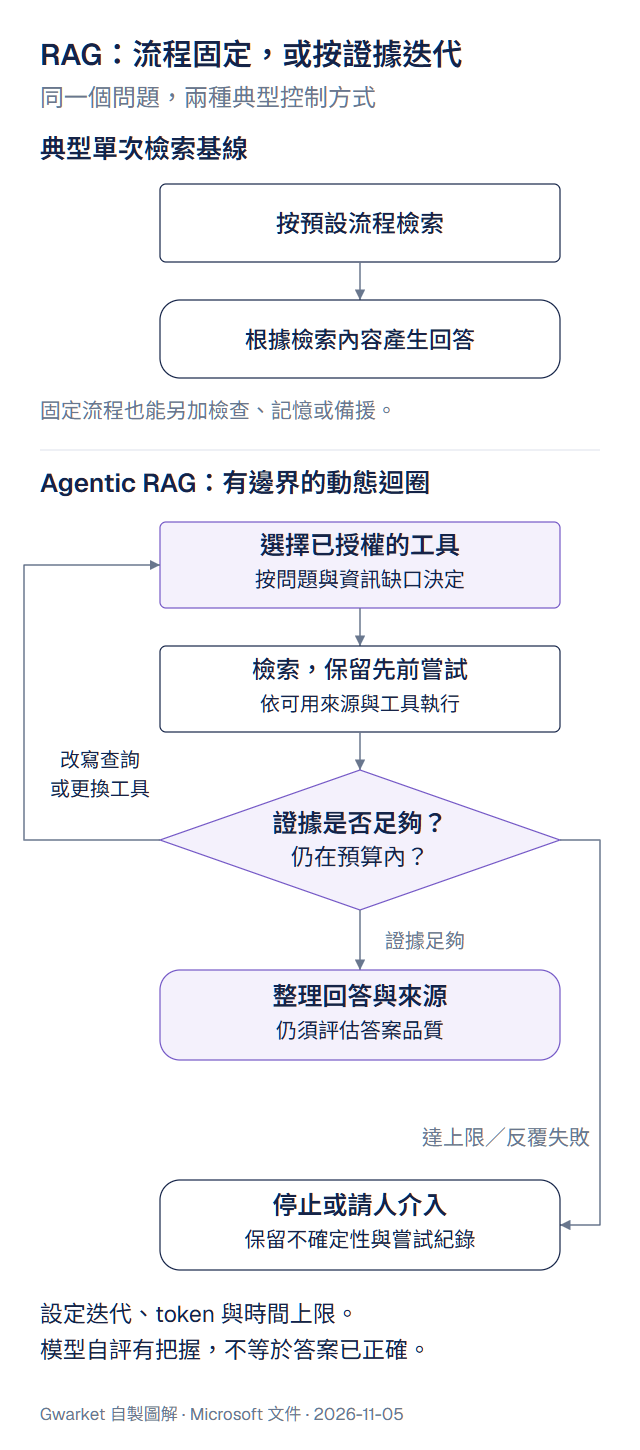
核心迴圈:maker-checker 模式
Agentic RAG 的運作模式是 5 步循環:
- Initial Call:用戶 prompt 進 LLM
- Tool Invocation:LLM 發現缺資訊 / 指令模糊、選 tool(vector DB query、SQL call、API)
- Assessment & Refinement:LLM 看回傳資料、決定夠不夠;不夠就 rewrite query / 換 tool / 換方法
- Repeat Until Satisfied:在迭代、token 與時間上限內重試;證據足夠則回答,達上限或反覆失敗則停止或請人介入
- Memory & State:全程記錄之前嘗試跟結果、避免在同個地方繞圈
這個架構的設計亮點:不需要複雜的 orchestration framework。微軟原文直接說「a relatively simple loop of LLM call → tool use → LLM call → … can yield sophisticated and well-grounded outputs」。多數團隊看到 Agentic RAG 想到的是 LangChain agent 那種複雜結構、實際上核心邏輯比想像中輕——重點是讓 LLM 擁有「決定下一步」的權限、而不是「設計複雜的 state machine」。
實戰範例(產品上線策略):模型自己決定要 (1) Bing 拉市場 trend report → (2) Azure AI Search 比對對手資料 → (3) Azure SQL 查內部銷售歷史 → (4) 合成策略 → (5) 自評有沒有 gap、有就回 step 1。每一步都不是人預設、是模型看當下品質決定。
Self-Correction 3 種失敗處理
Agentic RAG 的真正壓力測試是「失敗時怎麼辦」。微軟列了 3 種機制:
1. Iterate and Re-Query
拿到 irrelevant document 或 malformed query 結果時、不回低品質答案、改寫策略再試。具體包括:rewrite database query、換不同 search 方法、換 alternative dataset。這依賴模型評估結果與選擇工具的能力,不能只憑模型大小推定是否勝任;應以具體任務的檢索品質與工具選擇評估確認。
2. Diagnostic Tools
系統可以 call 額外 function 來 debug 自己——例如查 trace、驗證資料正確性。微軟特別提到 Azure AI Tracing 對 observability 很重要。對位第 4 篇「信任三層架構」的第 2 層 observability——Agentic RAG 因為步驟更多、observability 重要性比 traditional RAG 高很多。沒有 trace 你根本不知道模型在 4 步循環中第幾步出錯、改不了。
3. Fallback to Human Oversight
對 high-stakes 或反覆失敗的場景、模型應該標 uncertainty、請人類介入。這條容易被忽略——很多 Agentic RAG 設計只有「自動 retry」、沒有「retry N 次後 escalate」的明確 trigger。若缺乏停止條件,系統可能反覆重試並消耗預算;應設定迭代、token 與時間上限,必要時停止或請人介入。Escalation policy 是 Agentic RAG 的必要設計、不是 optional。
Agentic RAG 的邊界 — 不是 AGI
微軟特別澄清 Agentic RAG 不是「全自主 AI」:
- Domain-Specific Autonomy:自主在 user-defined 目標跟已知 domain 內、不能跨界
- Infrastructure-Dependent:能力綁開發者整合的 tool / data、無法自己發明新 tool
- Respect for Guardrails:ethical guidelines / compliance / business policy 永遠優先、autonomy 不能繞過
這 3 條邊界很重要——Agentic RAG 的「智能」是「在你給的工具箱裡靈活組合」、不是「無中生有」。實作時你給的 tool 集合就是 agent 能力的天花板。tool 不夠完整、agent 再聰明也不會超出。所以 Agentic RAG 設計工作不能只停在 agent prompt,還包括 tool inventory 設計——哪些 tool 應該存在、tool 之間如何互補、有沒有 fallback tool。
三個最適場景
微軟給的 3 個 use case:
- Correctness-First Environments:合規檢查、法規分析、法律研究——可接受多輪 LLM call 換 thoroughly vetted 答案
- Complex Database Interactions:結構化資料、query 經常失敗或需調整——Agentic RAG 自動 refine SQL 直到對齊用戶意圖
- Extended Workflows:長 session、新資訊持續浮現——系統持續整合、隨 problem space 演化策略
3 個場景的共通點:對「答案品質」的容忍度低、對「時間 / token cost」的容忍度高。如果你的場景反過來(要快、便宜、一次檢索已能達到任務要求),traditional RAG 更適合。
我的觀察 — 什麼時候別用 Agentic RAG
微軟給了適用場景、沒明說的是反面。3 種我會建議不用 Agentic RAG 的場景:
1. 高頻、低 stakes 的問答(如客服 FAQ)
用戶問「你們營業時間幾點」,如果一次檢索就能回答,先採 traditional RAG + 合適的 chunking + cached response。Agentic RAG 不必每題都跑固定四步;多輪推理是否值得,應比較實際答案品質、延遲與每次請求成本,不能用固定 5–10 倍當成通則。官方取捨與評估方式
2. Retrieval source 單一、結構穩定
Agentic RAG 的價值點在按需要調整查詢與 retrieval 方法。若只有一個穩定來源,且問題一次檢索即可解決,traditional RAG 通常是較合適的起點;單一來源仍可能有查詢拆解或反覆釐清的需求,不能只按來源數量斷言動態檢索沒有價值。
3. 沒有 observability / escalation 設計時
Agentic RAG 因為步驟多、debug 困難、沒 trace 等於黑盒。如果你的團隊還沒準備好上 OpenTelemetry + Azure AI Tracing 之類的工具、別急著上 Agentic RAG——出 bug 你不知道在哪步、用戶等更久、cost 失控。建議順序:先把 traditional RAG 的 observability 跟 evaluation 做好、再升級到 Agentic RAG。基礎建設沒就位、Agentic RAG 是 over-engineering。
Agentic RAG 在 gwarket 既有 RAG 系列中的位置
gwarket 之前的 RAG 系列討論過 chunking strategy、Hybrid Search、評估方法、實戰決策框架——那些是 traditional RAG 的優化主軸。Agentic RAG 是另一條軸:當你的 traditional RAG 已經優化到瓶頸、繼續調 chunk 跟 embedding 收益遞減時、考慮把推理 ownership 從你身上移到模型身上。
判斷時機:先用任務評估找出失敗原因,再判斷動態查詢、換來源或跨來源推理能否改善。若主要問題仍是 chunking、embedding 或資料品質,先修檢索基礎;不能用 80% 或 60% accuracy 當作通用升級門檻。把 Agentic RAG 與原 baseline 的答案品質、工具呼叫、延遲及成本一起比較。官方評估維度
常見問題
Agentic RAG 跟「multi-agent + RAG」有什麼差別?
不是同一件事。Multi-agent + RAG 是「多個 agent 各自 retrieve、再協作整合」——是架構選擇。Agentic RAG 是「單一 agent 擁有 retrieval 推理 ownership」——是推理模式選擇。兩者可以組合:multi-agent 系統內每個 agent 都用 Agentic RAG 模式。也可以分開:單 agent 也能跑 Agentic RAG、多 agent 也可以跑 traditional RAG(每個 agent 走預定 chain)。
Agentic RAG 的 cost 通常比 traditional RAG 高多少?
沒有適用所有系統的固定倍率。每次請求成本要加總模型推理、最終生成與檢索工具呼叫,並依所用模型、token、服務計價和實際迭代數計算。四個流程名稱不等於固定四次付費呼叫;先取得 traditional RAG baseline,再比較品質改善是否值得額外延遲與費用。官方每次請求成本說明
沒有 Azure 棧能做 Agentic RAG 嗎?
可以。Agentic RAG 是 paradigm 不是平台——核心是「LLM 擁有推理 ownership + 動態 tool selection + 跨步驟 memory」。支援工具呼叫的模型可作為核心,仍須接好 runtime、資料工具與停止條件,並評估該模型能否完成任務。Vector DB 可選 Qdrant / Pinecone / Weaviate / Chroma / pgvector。Tracing 可選 Langfuse / Arize Phoenix。微軟版本綁 Azure AI Search + Azure SQL + Azure AI Tracing 是整合便利、不是必要條件。
原文出處:Microsoft AI Agents for Beginners — Lesson 5 Agentic RAG
本系列共 6 篇:(1) 18 課完整目錄 (2) 5 種設計選型 (3) Context Engineering 深度 (4) 信任三層架構 (5) Browser-Use + MCP / A2A / NLWeb (6) Agentic RAG(本篇)
資料來源與查證日期: 本次圖解與必要限定依 Microsoft Lesson 5(固定來源719e2e08) 及 Azure Architecture Center(2026-06-30更新) 整理;查證日期:2026-11-05。